AI Agent 可觀測性之所以存在,是因為 AI Agent 的行為不像一般的網路服務。單一使用者請求可能觸發一連串內部決策——意圖分類、權限檢查、技能分派、模型推論、工具執行、子 Agent 委派,以及結果整合,這些全都發生在同一個 session 內。傳統 APM 只能顯示外層請求,卻很少能揭露中間發生了什麼。
TrueWatch Toby AI Agent Observability 正是為了填補這個缺口而打造。它讓團隊能以跨框架的視角檢視 Agent 行為:session、trace、span、模型呼叫、工具執行、Token 用量、風險事件,以及周邊的系統情境。
為什麼傳統 APM 並非為 Agent 而生
Agent 的核心執行單位並非 HTTP 請求,而是一條推理與行動鏈。單一任務可能包含意圖分析、權限檢查、技能分派、模型推論、檢索增強情境(RAG)、工具執行,以及子 Agent 委派。
標準 APM 仍能擷取周邊的服務呼叫、延遲與錯誤,但無法回答 Agent 團隊真正需要的問題:
- 推理鏈的每一步發生了什麼?
- 呼叫了哪些工具,是否成功執行?
- 哪個模型在哪一步執行,用了多少 Token?
- 這個工作流程是否觸發了風險政策?
- 父 Agent 如何將工作委派給子 Agent?
缺乏這樣的可視性,成本、風險與可靠性都只能靠猜測。
TrueWatch 的 AI Agent 可觀測性平台:以 OpenTelemetry 為基礎
TrueWatch 的 AI Agent 可觀測性平台運行於以 OpenTelemetry 為基礎的架構上,因此回報 Agent 行為時不需要更動核心業務邏輯。以 OpenClaw 為基礎的 Agent 而言,回報路徑如下:
openclaw-otel-plugin → DataKit → TrueWatchAgent 框架仍在快速演進,這正是共通遙測標準之所以重要的原因。OpenTelemetry 讓 TrueWatch 能將 Agent 行為,與團隊原本就仰賴的基礎設施 trace、服務 trace、日誌、指標及事件串接起來——而不需要為每個新框架各自打造一次性的轉接器。
AI Agent 可觀測性儀表板:Session 與 Trace 視圖
TrueWatch 的 AI Agent 可觀測性儀表板分為兩個層級運作。
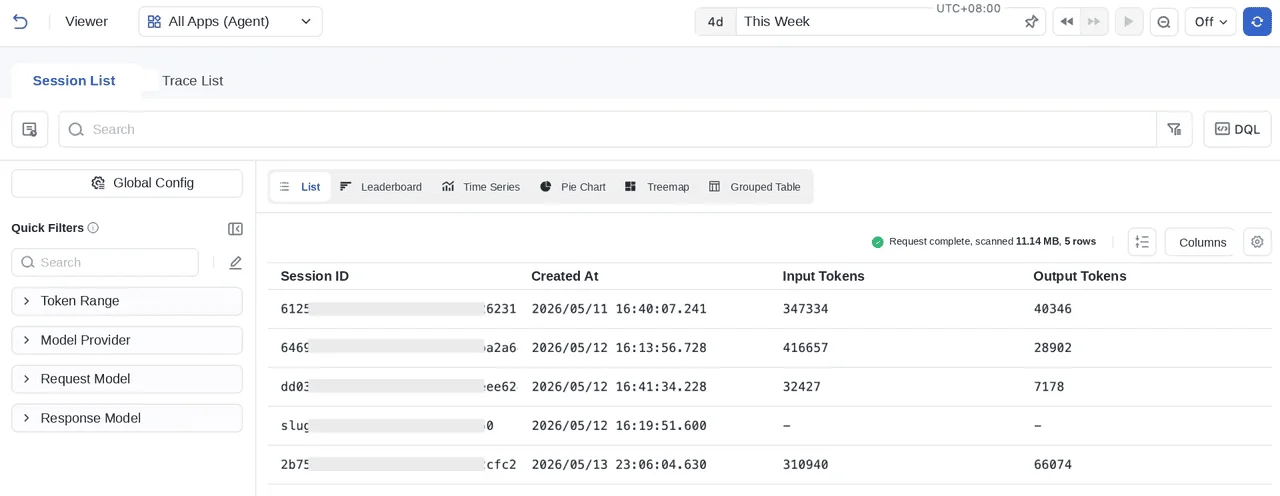
**Session 視圖。**每個 session 都彙整了一次完整的使用者互動——開始與結束時間、最新意圖、trace 數量、Token 總用量、風險事件數,以及警示等級。時間軸會標示異常活躍的時段、重複重試,或執行模式的突然變化。
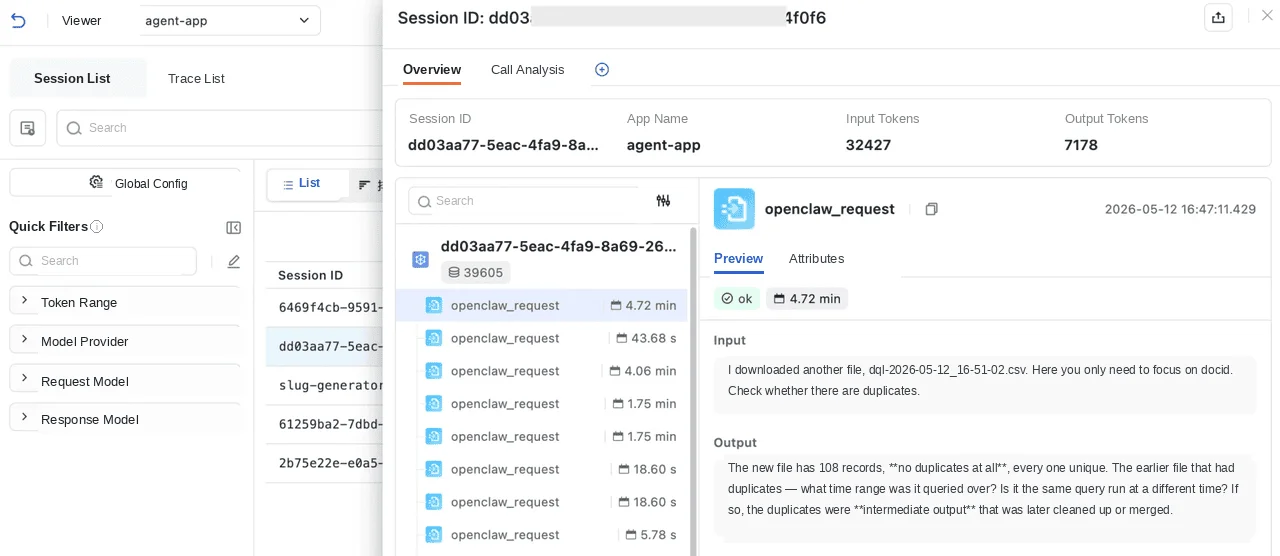
**Trace 視圖。**在 session 內,trace 瀑布圖會逐步呈現整條執行鏈:意圖分類、Prompt 格式化、模型請求、檢索、工具呼叫,以及輸出生成。每個 span 都帶有耗時、Token 數、狀態,以及(在政策允許的情況下)輸入/輸出的詳細內容。這就是 AI Agent 追蹤在實務上的樣貌——不是單一組請求/回應,而是讓中間的每個決策點都變得可見、可搜尋。
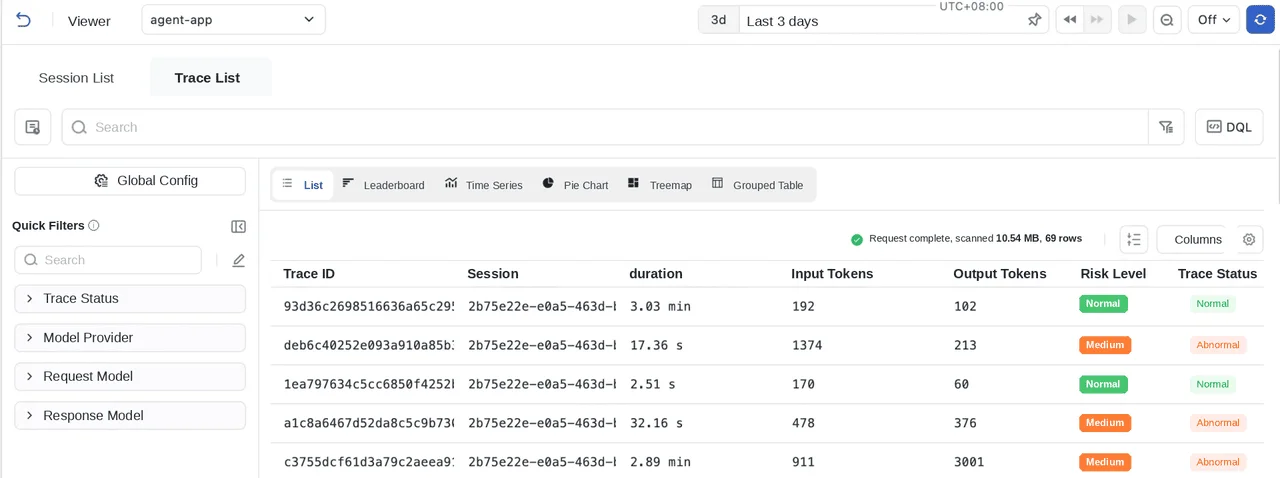
在 trace 清單層級,工程師可以依 trace ID、Agent 名稱、風險等級、Token 範圍或狀態進行篩選,快速找出高風險或異常的執行。
成本層面的 AI Agent 監控:跨模型與工具的歸因
Agent 的成本波動幅度遠大於一般服務的資源使用量。同一個面向使用者的功能,可能因為 Prompt、檢索結果、所選模型、重試行為,或涉及的工具鏈不同,而消耗截然不同的 Token 量。
TrueWatch 的 AI Agent 監控視圖會拆解 session 內模型呼叫與工具執行之間的佔比,讓團隊能夠回答:
- 哪個模型佔用最多 Token?
- 重排序(reranking)觸發的頻率是否過高?
- 讀檔工具是否增加了延遲?
- 外部 API 是否才是真正的瓶頸?
- 哪個 session 或 trace 導致了異常成本?
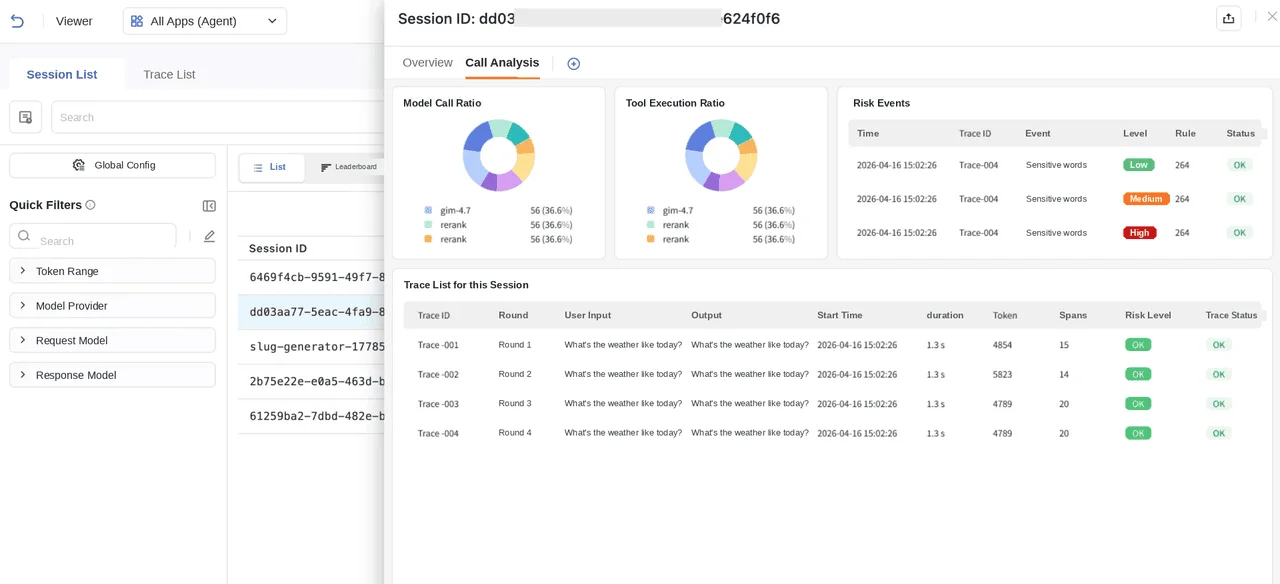
這正是 Agent 可觀測性成為 FinOps 一環的地方。目標不是等帳單來了才數 Token,而是將成本直接連結到 Agent 行為、模型選擇、工具使用,以及觸發這一切的產品工作流程。
AI Agent 治理:Agent 行動的風險審計
一旦 Agent 觸及生產環境的資料或工具,可觀測性就成了一項治理功能。
TrueWatch 的 trace 詳細視圖會呈現風險事件——內容政策檢查、敏感詞過濾、權限邊界檢查,以及其他政策訊號——每一項都對應到 span ID、嚴重程度、規則與執行情境。工具執行記錄也以同樣精確的方式記錄:時間戳記、span ID、工具名稱、工具類型、目標或指令、耗時、狀態,以及風險等級。
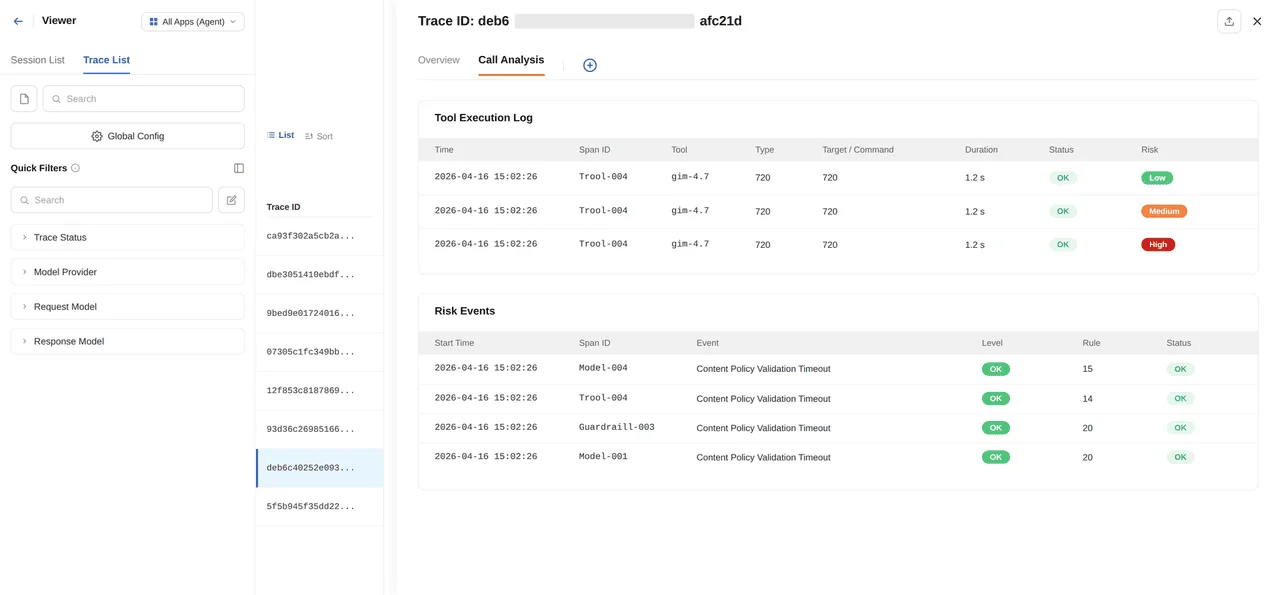
這為團隊提供了一條證據軌跡。當 Agent 出現非預期行為時,團隊可以精確追蹤是哪個工具執行了、使用了什麼情境、觸發了哪項政策,以及人工核准步驟該安插在哪個環節。
在 TrueWatch 中設定 AI Agent 監控
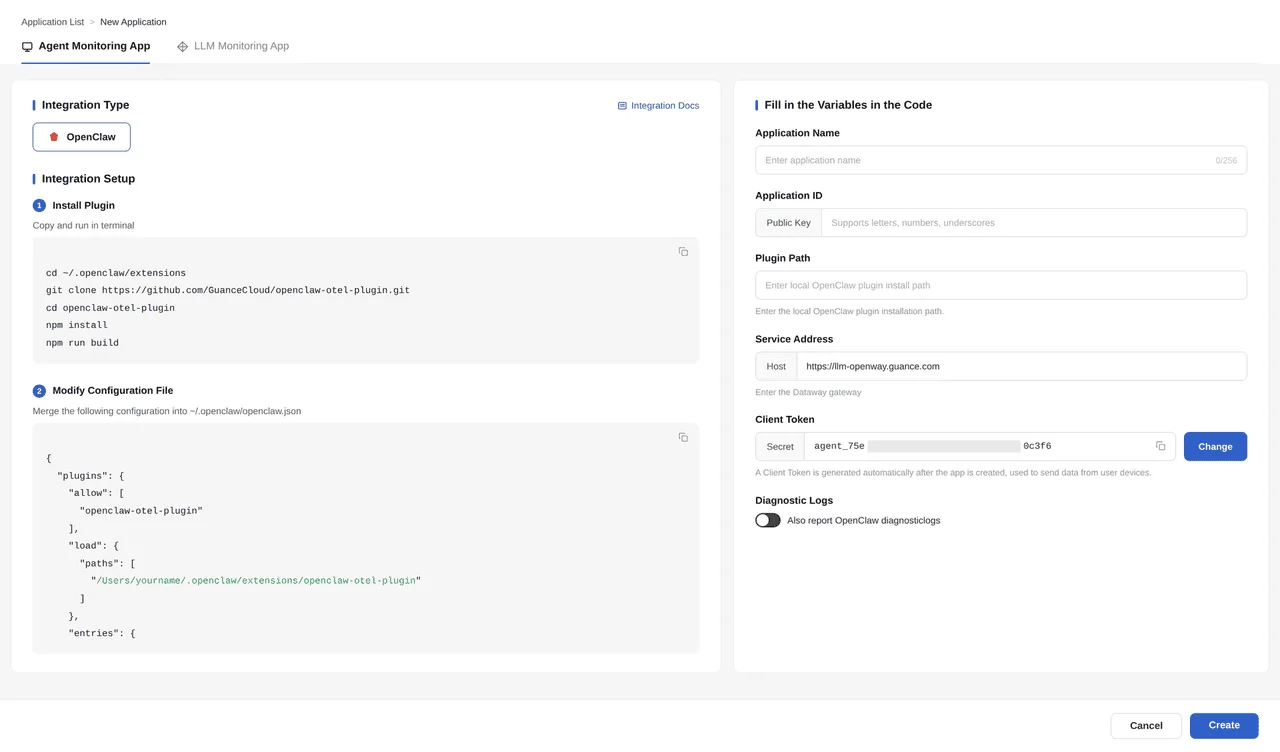
TrueWatch 主控台提供專屬的應用程式路徑,分別對應 Agent 監控與 LLM 監控。以 OpenClaw Agent 而言,設定只需三個步驟:
- 安裝外掛(plugin)。
- 更新設定檔。
- 重新啟動並驗證回報是否正常。
設定表單會自動產生應用程式名稱、應用程式 ID、服務位址,以及客戶端 Token。
跨框架的 AI Agent 可觀測性工具
Agent 生態系相當分散——OpenClaw、Hermes、LangChain、CrewAI、程式碼撰寫 Agent,以及企業內部自建的 Agent,各自採用不同的執行模型。TrueWatch 以 OpenTelemetry 作為共通基礎,讓團隊擁有單一的遙測模型,而不必為每個框架各自打造轉接器。
**OpenClaw。**其閘道架構與外掛模型天生就適合 OpenTelemetry 回報,能在單一實例或多 worker 部署間,保留 session 情境與分散式 trace。
**Claude Code 與 Codex。**這裡的方向是將程式碼撰寫 Agent 的行為,與傳統服務 trace 連結起來,讓團隊能夠追蹤如下路徑:
agent decision → API call → service trace → database query程式碼撰寫 Agent 不該是與它所變更或調查的系統各自獨立的黑盒子——它應該留下能與服務、日誌、指標及 trace 接軌到同一套生產環境情境的遙測資料。
結論
Agent 的能力正快速提升,而信任才是更困難的課題。TrueWatch AI Agent Observability 將 LLM 可觀測性、session、trace、模型與工具成本歸因、風險審計,以及跨框架遙測整合到單一操作視圖中——讓 Agent 行為變得可審查、可治理,並與其所觸及的生產系統相互連結。
常見問題
Q: 什麼是 AI Agent 可觀測性? A:AI Agent 可觀測性是一種追蹤 AI Agent 完整推理與行動鏈的做法——涵蓋意圖分類、模型呼叫、工具執行,以及子 Agent 委派——而不僅是傳統 APM 所擷取的外層 API 請求。
Q: 監控 AI Agent 成本的最佳方式是什麼? A:有效的 AI Agent 監控會將 Token 用量與支出,歸因到 session 內特定的模型、工具與工作流程步驟,而不是在應用程式層級彙總成本。這讓成本追蹤成為可付諸行動的 FinOps 輸入,而不是每月才發現的驚喜。
Q: 支援跨框架的最佳 AI Agent 可觀測性工具是什麼? A:請選擇建立在如 OpenTelemetry 等開放標準之上的 AI Agent 可觀測性工具,因為 Agent 框架(OpenClaw、LangChain、CrewAI、程式碼撰寫 Agent)仍在持續演進,而共通的遙測模型可以避免為每個框架各自進行整合。
Q: 可觀測性平台中的 AI Agent 治理如何運作? A:AI Agent 治理會將每個風險事件——政策檢查、權限邊界、敏感內容過濾——與觸發它的 span、嚴重程度及執行情境相互對應,藉此建立 Agent 如何行動、為何行動的審計軌跡。
Q: AI Agent 可觀測性能否涵蓋多 Agent 系統? A:可以。多 Agent 可觀測性(multi agent observability)需要追蹤父 Agent 如何委派給子 Agent,並在整條委派鏈中保留 session 情境,而不僅是最上層的請求。
Q: 什麼是 AI Agent 追蹤(tracing)? A:AI Agent 追蹤是逐步記錄 Agent 執行鏈的方式——涵蓋意圖分類、模型呼叫、工具執行,以及子 Agent 委派——以一系列 span 組成的瀑布圖呈現,而不是單一的請求/回應日誌。這使得 Agent 的推理過程變得可審查,而不再是一個黑盒子。
